
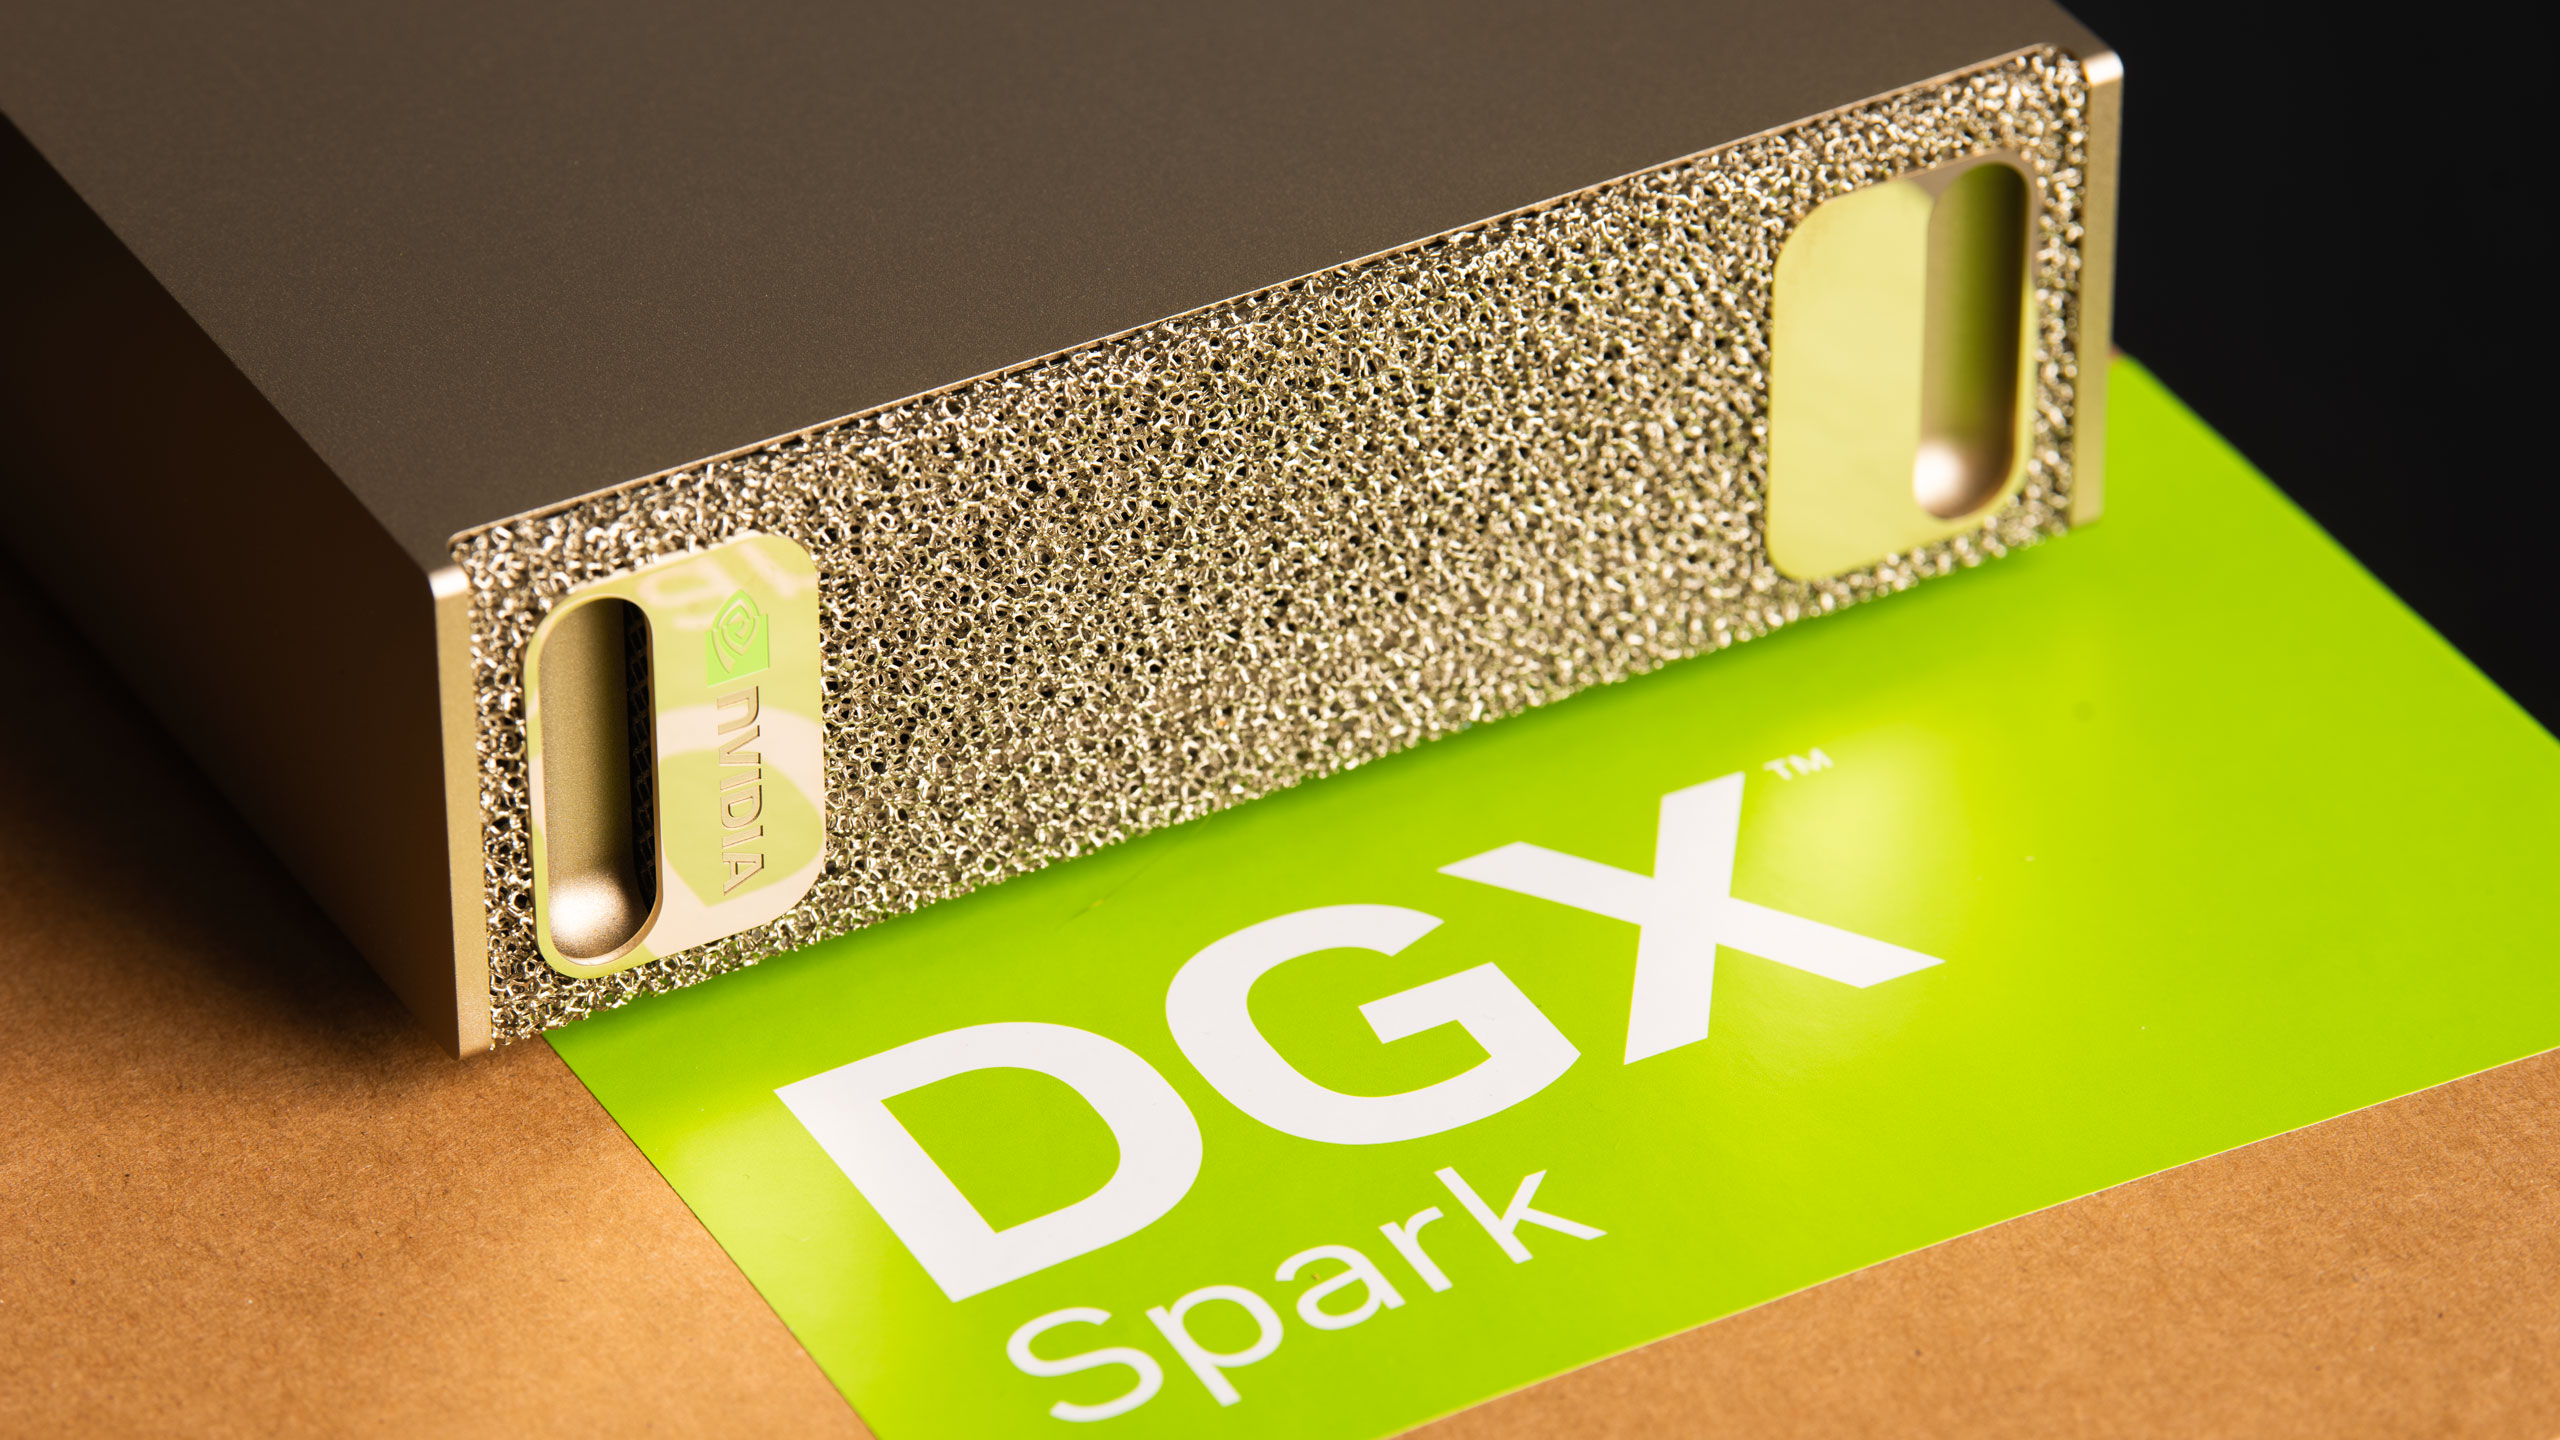
Olympic.or.id – Kabar mengejutkan mendadak mengguncang jagat teknologi global! Secara tak terduga, raksasa chip dunia, Nvidia, melipatgandakan variasi lini komputer kecerdasan buatan (AI) desktop andalannya dengan merilis amunisi terbaru dari seri DGX Spark. Menariknya, Nvidia kali ini secara resmi menghadirkan varian “hemat” yang mengusung RAM sebesar 64 GB saja. Kapasitas memori teranyar ini secara signifikan memangkas tepat separuh dari kapasitas monster 128 GB yang sebelumnya menguasai pasar AI workstation.
Langkah berani ini sejatinya menjadi strategi brilian Nvidia untuk merangkul para pengembang dan praktisi AI yang mendesak ingin menjalankan model AI secara lokal tanpa harus menguras kantong secara berlebihan. Selain itu, peluncuran varian anyar ini sekaligus menjadi jawaban langsung Nvidia atas lonjakan harga komponen memori dunia yang makin tak terkontrol saat ini. Pasalnya, ketika sang manufaktur pertama kali memamerkan monster DGX Spark ke hadapan publik, semua orang menganggap memori berkapasitas raksasa sebagai harga mati untuk mengeksekusi model AI tingkat lanjut di perangkat lokal.
Oleh sebab itu, produsen teknologi dunia berlomba-lomba meluncurkan sistem berbasis Nvidia GB10, AMD Strix Halo, hingga Apple M-Series dengan amunisi RAM jumbo 128 GB atau bahkan lebih. Akan tetapi, lanskap arsitektur kecerdasan buatan belakangan ini justru mengalami evolusi efisiensi yang luar biasa pesat. Sebagai gambaran nyata, model padat (dense model) generasi baru seperti Qwen 3.8 27B kini sanggup berlari kencang hanya dengan modal RAM 32 GB, meskipun pengguna harus mengorbankan panjang konteks pemrosesan. Alhasil, para praktisi AI menyadari bahwa kapasitas monster 128 GB pada lini DGX Spark sebetulnya tidak selalu menjadi syarat wajib demi mengeksekusi kebutuhan local inference harian.
Solusi Rasional di Tengah Lonjakan Harga Memori Global
Di sisi lain, lonjakan harga RAM global yang kian meroket secara otomatis mengerek biaya produksi komponen LPDDR5X berkapasitas besar hingga melonjak drastis. Akibatnya, harga jual akhir perangkat komputer workstation pun ikut membumbung tinggi dan makin sulit terjangkau. Karena alasan krusial itulah, para teknisi senior di Nvidia memandang varian 64 GB sebagai solusi paling rasional dan ramah kantong bagi para pengembang yang mendambakan kebuasan Superchip GB10 serta ekosistem perangkat lunak Nvidia, tanpa harus membayar mahal untuk memori yang tak terpakai.
Meski produsen sudah memotong kapasitas memorinya hingga setengahnya, faktanya label harga DGX Spark 64 GB ini masih berada di jajaran kasta tertinggi. Nvidia mengonfirmasi bahwa deretan vendor PC papan atas dunia—seperti Acer, Asus, Dell, Gigabyte, HP, hingga MSI—akan menjajakan sistem GB10 versi 64 GB ini mulai 23 Oktober mendatang dengan mahar mulai dari 4.999 dollar AS (setara Rp 89,4 juta rupiah). Namun, calon pembeli harus bersiap menghadapi potensi pergeseran harga, mengingat fluktuasi harga komponen memori dan penyimpanan data di pasar global masih amat dinamis.
Guna memberikan gambaran nyata, harga varian baru ini sejatinya jauh lebih terjangkau apabila kita membandingkannya langsung dengan versi premium 128 GB. Saat ini, para distributor masih melego sistem GB10 bermemori 128 GB di kisaran angka fantastis, yakni 7.000 hingga 9.000 dollar AS (sekitar Rp 125 juta hingga Rp 161 juta rupiah). Sontak saja, selisih harga yang amat jauh ini membuat opsi 64 GB langsung menjadi magnet baru bagi kalangan pebisnis startup maupun peneliti individual.
Performa Monster Tetap Ganas dan Siap Di-Cluster
Lantas, apakah pemangkasan RAM ini menurunkan kegarangan performanya? Jawabannya adalah sama sekali tidak! Nvidia menegaskan bahwa mereka tidak sedikit pun mengurangi atau menyunat spesifikasi utama dari superkomputer AI mini garapan mereka. Lebih lanjut, DGX Spark 64 GB ini tetap memboyong kartu jaringan kelas berat ConnectX 7 RDMA NIC, eksak sama seperti yang terpatri pada model flagship 128 GB.
Kehadiran fitur konektivitas super cepat ini sengaja Nvidia pertahankan agar pengguna dapat secara fleksibel menghubungkan beberapa unit Spark sekaligus dalam satu jaringan paralel. Dengan demikian, para teknisi dapat melipatgandakan kapasitas memori serta mendongkrak performa inference secara drastis apabila suatu saat nanti alur kerja mereka membutuhkan daya RAM melebihi 64 GB.
Tak hanya itu, dapur pacu utama komputer ini masih mengandalkan ketangguhan CPU Arm 20-core yang sangat perkasa untuk melahap beban kerja seberat apa pun. Bahkan, Nvidia tetap mempertahankan angka bandwidth memori yang amat fantastis, yakni mencapai 273 GB/s yang terbagi rata untuk kebutuhan CPU maupun GPU demi menjamin tidak adanya kendala leher botol (bottleneck).
Kendati varian 64 GB siap menggebrak pasar, Nvidia meluruskan bahwa kehadiran produk anyar ini tidak serta-merta menggusur atau menghapus keberadaan model 128 GB. Perusahaan memastikan bahwa varian monster 128 GB akan tetap beredar luas di pasaran khusus untuk memanjakan para kreator yang menggeluti eksekusi model AI skala raksasa, pembangunan cluster tingkat lanjut, hingga proses fine-tuning model komprehensif yang memang rakus memori.
Bikin Cluster AI Makin Kilat Lewat Nvidia Sync Assistant
Demi memaksimalkan potensi gila dari teknologi jaringan ConnectX 7 tersebut, Nvidia secara bersamaan memperkenalkan amunisi lunak terbaru bernama Nvidia Sync Cluster Assistant. Perangkat lunak mutakhir ini mengusung kemampuan untuk mengotomatiskan seluruh proses rumit saat menyatukan beberapa perangkat Spark menjadi satu kesatuan cluster pemrosesan yang solid.
Inovasi perangkat lunak ini secara otomatis melengkapi sekaligus menyempurnakan berbagai perkakas (tools) buatan komunitas yang sebelumnya telah beredar luas untuk memudahkan penggabungan beberapa sistem GB10. Dengan hadirnya dukungan resmi ini, para pengembang kini tidak perlu lagi melakukan penyetelan manual yang memakan waktu berjam-jam.
Bahkan, Nvidia melengkapi aplikasi Sync ini dengan fitur pintar baru yang berlabel Model Launcher. Lewat fitur ajaib ini, pengguna dapat mengunduh sekaligus mengeksekusi model AI ternama seperti Qwen 3.8 27B secara otomatis penuh, baik pada satu unit komputasi tunggal maupun langsung tersebar di dalam cluster multi-sistem.
Menariknya lagi, sistem cerdas ini sanggup terhubung secara langsung dan mulus ke OpenCode, yang merupakan agen pemrogram berbasis peramban (browser). Alhasil, para praktisi pemrograman kini dapat memanfaatkannya secara instan untuk menggenjot berbagai alur kerja agen berbasis AI (agentic workflow) lokal dengan kecepatan luar biasa, sebagaimana dilaporkan secara mendalam oleh situs berita teknologi Tom’s Hardware.
Temukan juga berbagai berita terbaru lainnya hanya di Exposenews.id.