
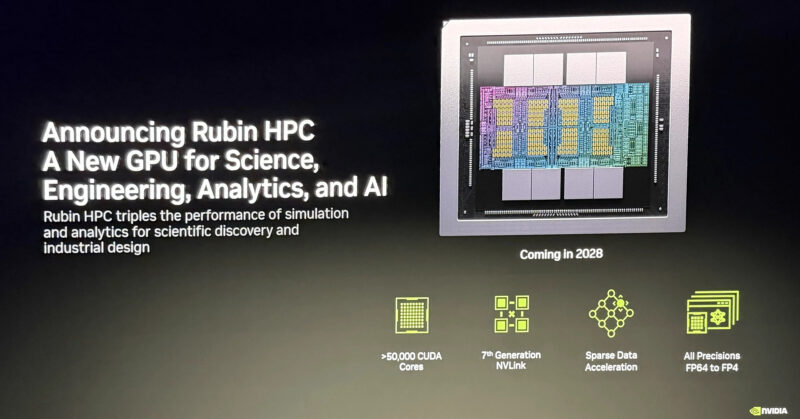
Olympic.or.id – Nvidia kembali mengejutkan dunia komputasi dengan memperkenalkan unit pengolah grafis (GPU) terbarunya bernama Rubin HPC dalam ajang tahunan bergengsi Supercomputing 2026 (SC26) yang berlangsung di Chicago, Amerika Serikat, Senin (16/11/2026).
Bukan untuk bermain gim, Nvidia merancang GPU monster ini khusus guna menaklukkan beban kerja high-performance computing (HPC), mulai dari simulasi ilmiah, perhitungan teknik, hingga pengolahan mahadata superbesar.
Menariknya, sorotan paling mencolok dari Rubin HPC terletak pada jumlah CUDA core yang menembus 50.000 unit lebih, sekaligus memecahkan rekor jumlah inti terbanyak yang pernah Nvidia benamkan dalam satu GPU.
Lompatan Fantastis Jumlah CUDA Core dan Cara Kerjanya
Sebagai gambaran perbandingan yang bikin melongo, GPU Nvidia B300 berbasis arsitektur Blackwell Ultra hanya mengantongi 20.480 CUDA core, sedangkan seri Rubin standar cuma membawa 28.672 CUDA core.
Artinya, Rubin HPC menawarkan kapasitas pemrosesan sekitar 2,4 kali lebih melimpah ketimbang seri B300, sekaligus mengungguli saudara kandungnya, Rubin standar, sekitar 1,7 kali lebih banyak.
Secara sederhana, kita bisa membayangkan CUDA core sebagai ribuan pekerja mini di dalam GPU yang bekerja serentak, sehingga semakin banyak jumlahnya, semakin melimpah pula kalkulasi teoritis dalam satu waktu.
Meskipun demikian, melimpahnya CUDA core tidak otomatis membuat sebuah GPU melesat paling kencang, sebab performa akhir tetap bergantung pada kecepatan memori serta kelancaran pengiriman data menuju inti pemrosesan.
Senjata Rahasia untuk Menaklukkan Simulasi Ilmiah Tingkat Dewa
Lebih jauh lagi, tim insinyur Nvidia memang memfokuskan Rubin HPC untuk melibas berbagai pekerjaan komputasi ilmiah dan teknik yang menuntut kalkulasi berskala raksasa, sehingga GPU ini siap menjadi tulang punggung riset modern.
Sebagai bagian penting dari platform Nvidia Vera Rubin, akselerator ini sanggup menangani pemodelan iklim global, simulasi desain rekayasa, analisis genom biologis, hingga perhitungan risiko rumit di sektor keuangan.
Guna mempercepat pekerjaan berat tersebut, Nvidia turut menyematkan teknologi pintar bernama sparse data acceleration yang membantu GPU mengolah potongan data tersebar di berbagai sudut memori secara lebih efisien.
Hasilnya, unit pemrosesan utama di dalam GPU tidak perlu membuang waktu lama hanya untuk menunggu antrean data sebelum mulai berhitung, sehingga efisiensi komputasi meningkat secara signifikan.
Selain itu, Nvidia juga mengoptimalkan Rubin HPC untuk melibas kalkulasi khas riset ilmiah, mencakup matriks dengan banyak nilai kosong, perhitungan titik data sekitar, pengurutan variabel, hingga penyederhanaan data raksasa menjadi ringkasan padat.
Dukungan NVLink 7 yang Bikin Riset AI Makin Ngebut
Tidak berhenti sampai di situ, Nvidia juga membekali Rubin HPC dengan jalur komunikasi supercepat NVLink generasi ketujuh alias NVLink 7 agar antar-GPU saling bertukar data secara instan.
Sebagai gambaran perbandingan, NVLink generasi sebelumnya pada platform Vera Rubin menawarkan bandwidth dua arah hingga 3,6 TB per detik per GPU, namun Nvidia masih merahasiakan kemampuan resmi NVLink 7.
“Bagi agen kecerdasan buatan yang menangani persoalan sains maupun teknik, simulasi yang lebih cepat berarti proses penemuan juga berlangsung lebih cepat,” ujar Ian Buck, VP Hyperscale and HPC Nvidia, dikutip dari laporan resmi TechTimes pada Rabu (18/11/2026).
Menurut penjelasan ahli dari Buck, semakin ngebut sebuah simulasi berjalan, semakin gesit pula sistem AI menguji ribuan kemungkinan baru dalam riset.
Pada akhirnya, terobosan ini memungkinkan para ilmuwan dan insinyur menjajal jauh lebih banyak skenario eksperimen dalam waktu singkat sebelum menentukan langkah pengembangan berikutnya.
Eits, Jangan Senang Dulu! Spesifikasi Lengkapnya Masih Misteri
Kendati sudah memamerkan angka fantastis 50.000 lebih CUDA core, Nvidia nyatanya masih menahan diri untuk membocorkan keseluruhan spesifikasi teknis Rubin HPC kepada publik maupun para pengamat teknologi dunia.
Faktanya, sejumlah informasi krusial memang belum perusahaan umumkan, meliputi kapasitas memori, kecepatan transfer data keluar-masuk memori, besaran konsumsi daya listrik, hingga kemampuan menjalankan perhitungan presisi tinggi FP64.
Padahal, rincian data teknis tersebut memegang peranan vital karena performa nyata sebuah superkomputer tidak melulu bergantung pada seberapa cepat GPU berhitung di atas kertas.
Dalam sejumlah beban kerja kompleks, kecepatan sistem justru sangat bergantung pada seberapa kilat jalur memori memindahkan data menuju GPU dan menariknya kembali.
Bukti Nyata dari Superkomputer El Capitan hingga Jadwal Rilis
Sebagai bukti nyata di lapangan, pemeringkatan superkomputer TOP500 edisi Juni 2026 mencatat bahwa superkomputer raksasa El Capitan meraih kinerja 1,809 exaflops dalam pengujian LINPACK.
Sebagai catatan teknis, pengujian LINPACK memang dirancang khusus untuk mengukur kemampuan murni sistem dalam menyelesaikan perhitungan matematis berskala raksasa.
Namun uniknya, saat menjalani pengujian HPCG yang lebih mencerminkan beban kerja bergantung pada kecepatan akses dan perpindahan data, performa El Capitan justru anjlok ke angka 17,41 petaflops.
Perbedaan skor yang bak bumi dan langit tersebut membuktikan bahwa kemampuan menghitung dalam jumlah besar bukanlah satu-satunya penentu kehebatan sebuah superkomputer modern.
Oleh karena itu, klaim 50.000 lebih CUDA core milik Rubin HPC belum bisa kita jadikan tolok ukur tunggal untuk menilai lompatan kecepatannya.
Selain merahasiakan detail spesifikasi jeroannya, pihak Nvidia juga belum mengumumkan banderol harga resmi maupun konfigurasi sistem yang kelak mengadopsi GPU Rubin HPC di pusat data masa depan.
Sebagai penutup, GPU supercanggih ini dijadwalkan baru tersedia pada 2028 mendatang, sebagaimana informasi yang dihimpun dari TechTimes serta blog resmi Nvidia.
Temukan juga berbagai berita terbaru lainnya hanya di Exposenews.id.